
En el ecosistema del Big Data, la capacidad de capturar y procesar grandes volúmenes de datos en tiempo real se ha convertido en una necesidad crítica para las organizaciones.
A medida que la generación global de datos se incrementa a un ritmo superior al 12% anual, los sistemas de almacenamiento por lotes tradicionales resultan insuficientes para responder a eventos inmediatos.
En este escenario destaca Apache Kafka, una de las herramientas de código abierto de la Apache Software Foundation más utilizadas para la gestión de flujos contínuos de información (event streaming).
A lo largo de esta guía técnica analizaremos qué es Apache Kafka, su arquitectura interna de publicadores y suscriptores, sus componentes fundamentales (topics, brokers, particiones y réplicas), la transición de ZooKeeper a KRaft y cómo empezar a construir canales de mensajería masivos.
¿Qué es Apache Kafka?
Apache Kafka es una plataforma distribuida de transmisión de eventos escrita en Java y Scala.
Conceptualmente, Kafka actúa como un sistema de mensajes pub/sub (Publisher/Subscriber) de alto rendimiento capaz de gestionar millones de eventos por segundo con latencias de submilisegundos.
En lugar de almacenar información en estructuras estáticas tradicionales, Kafka trata los datos como un flujo continuo de paquetes pequeños de información.
Esto permite canalizar grandes archivos o registros de actividad inmediata (como publicaciones en redes sociales, transacciones financieras o lecturas de sensores IoT) sin importar el volumen enviado.
Al funcionar como un buffer intermedio o sujetador de mensajes, Kafka permite desacoplar los sistemas que producen datos de las aplicaciones encargadas de consumirlos y analizarlos.
| Característica | Apache Kafka | Mensajería Tradicional (ej. RabbitMQ) |
|---|---|---|
| Arquitectura principal | Registro de eventos distribuido e inmutable. | Agente de colas de mensajes (Broker de enrutamiento). |
| Persistencia de datos | Retiene eventos en disco según tiempo configurable. | Elimina mensajes tras confirmación de lectura. |
| Rendimiento de procesamiento | Millones de eventos/segundo mediante I/O secuencial. | Miles de mensajes/segundo según lógica de enrutamiento. |
| Reconstrucción de eventos | Permite relanzar o releer eventos pasados (replay). | No permite la relectura una vez consumidos. |
Componentes fundamentales de la arquitectura de Kafka
Para comprender cómo opera el procesamiento en tiempo real, es necesario distinguir los elementos que conforman la topología de Apache Kafka:
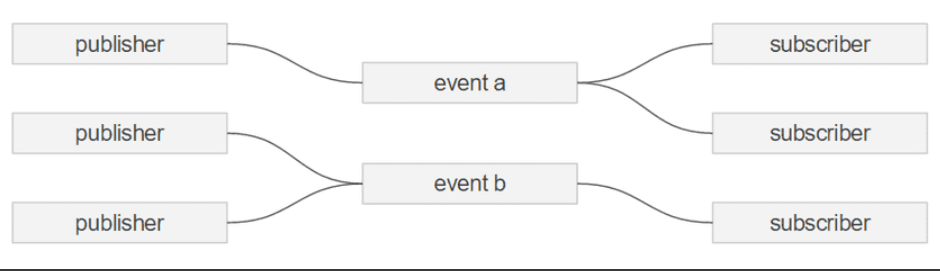
1. Modelo Pub/Sub (Publishers y Subscribers)
La transmisión de datos involucra dos figuras principales:
- Publishers (Productores): Aplicaciones que generan y envían registros de datos hacia el clúster de Kafka.
- Subscribers (Consumidores): Aplicaciones que leen y procesan los datos almacenados en Kafka.
2. Eventos / Mensajes
Un mensaje o evento es la unidad básica de información que se inserta en el sistema.
En Kafka, cada mensaje se compone de cuatro partes estructurales: header (metadatos), timestamp (marca de tiempo), clave (key, utilizada para definir la distribución en particiones) y valor (payload con los datos reales en formato JSON, Avro o String).
3. Topics
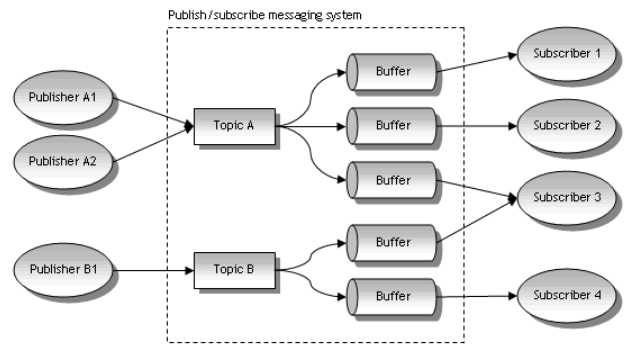
Un topic es la categoría o canal lógico donde se organizan y almacenan los mensajes enviados por los productores.
Los consumidores se suscriben a uno o varios topics específicos para leer y procesar la información de forma aislada.
Estructura interna: Brokers, Particiones y Réplicas
El rendimiento distribuido de Kafka se apoya en una infraestructura escalable:
- Kafka Broker: Cada servidor individual que forma parte del clúster de Kafka. Los brokers reciben los mensajes, los escriben en disco y los entregan a los consumidores.
- Particiones: Cada topic se divide en múltiples particiones distribuidas entre los diferentes brokers del clúster. Esto permite dividir la carga de trabajo y procesar datos en paralelo.
- Offset: Un identificador numérico secuencial e incremental asignado a cada mensaje dentro de una partición, que indica su posición exacta para garantizar el orden de lectura.
- Réplicas y Tolerancia a Fallos: Para garantizar la continuidad del servicio frente a caídas de servidores, cada partición cuenta con copias de respaldo (réplicas) asignadas a otros brokers. El factor de replicación define cuántas copias existen en el clúster.
Servicios de coordinación: De ZooKeeper a KRaft
Históricamente, la administración distribuida del clúster requería la integración de ZooKeeper, un servicio que mantiene la configuración del árbol de nodos (Znodes) y coordina la elección del broker líder.
En el desarrollo moderno de Apache Kafka, ZooKeeper se ha sustituido por KRaft (Kafka Raft Metadata Mode).
KRaft integra la gestión de metadatos directamente dentro del clúster de Kafka, simplificando la arquitectura, reduciendo el consumo de memoria y permitiendo escalar a millones de particiones sin dependencias externas.
Modelos de transmisión: Cola frente a Publicador/Suscriptor
Dependiendo de la configuración del proyecto, Kafka permite adaptar la entrega de mensajes bajo dos patrones:
- Modelo de Cola (Queue): Un grupo de consumidores comparte la lectura de un topic. Cada mensaje es entregado a un único consumidor dentro del grupo, distribuyendo la carga equitativamente.
- Modelo Publicador/Suscriptor (Pub/Sub): Múltiples grupos de consumidores se suscriben al mismo topic. En este caso, cada grupo recibe una copia completa del mensaje para procesarlo de forma independiente (por ejemplo, un grupo guarda en base de datos mientras otro alimenta un panel analítico).
Cómo crear un Topic en Apache Kafka
Para crear un topic desde la línea de comandos (CLI) especificando el número de particiones, el factor de replicación y la ruta de conexión, se utiliza el script oficial:
# Comando de creación de un topic con 4 particiones y réplica 2
kafka-topics.sh --bootstrap-server localhost:9092 --create --topic topicTest --partitions 4 --replication-factor 2
Tutorial práctico de instalación y configuración de Kafka
Para profundizar en su instalación y ver un ejercicio práctico paso a paso, puedes visualizar la siguiente sesión interactiva:
El perfil del Kafka Engineer en el mercado de Big Data
Especializarse como Kafka Engineer o arquitecto de datos en tiempo real es una de las rutas profesionales más cotizadas del sector IT.
Estos perfiles se encargan de diseñar tuberías de datos (pipelines ETL/ELT), integrar Kafka Connect con bases de datos relacionales/NoSQL y desarrollar aplicaciones analíticas en tiempo real utilizando la librería Kafka Streams.
Cómo conectar el procesamiento de datos con tu futuro laboral
Dominar tecnologías de streaming e integración en clústeres distribuidores te capacitará para acceder a posiciones de alta responsabilidad en ingeniería de datos.
Si estás organizando tu mapa de decisiones, te invitamos a consultar nuestra guía sobre qué aprender primero en programación.
Comprender cómo se integran los mensajes en arquitecturas corporativas evaluando la diferencia entre frontend, backend y full stack te ayudará a estructurar soluciones completas.
Durante la construcción de tus scripts y productores en Java o Scala, administrarás versiones sabiendo qué es Git y por qué es tan importante para trabajar en equipo.
A nivel de persistencia de información en los repositorios de datos finales, verificarás transacciones seguras comprobando qué es ACID en bases de datos.
En organizaciones avanzadas que automatizan el despliegue de modelos predictivos alimentados por Kafka, este aprendizaje conecta directamente con entender qué es MLOps y por qué es clave en ingeniería de software.
Para aquellos desarrolladores que buscan especializarse en la gestión de infraestructura en la nube para soportar clústeres de Kafka, recomendamos explorar el Programa Técnico Avanzado en DevOps con IA y LLMops.
Conclusión
En definitiva, dominar Apache Kafka te permite diseñar arquitecturas distribuidas capaces de procesar flujos de eventos masivos con alta disponibilidad y tolerancia a fallos.
La combinación del patrón Pub/Sub con una estructura de topics y particiones escalables convierte a Kafka en la columna vertebral de las canalizaciones de datos modernas.
Aprender la práctica real del Big Data con la guía de mentores en activo es el acelerador más potente para transformar tu perfil profesional.
Si quieres aprender Apache Kafka, Spark, Scala, Python, desarrollo de arquitecturas distribuidas de datos y Machine Learning con proyectos reales y contar con el apoyo de nuestra Bolsa de Talento activa, descubre el Bootcamp Full Stack Big Data & Machine Learning de KeepCoding y da el paso definitivo hoy mismo.
Al ser un proyecto de código abierto, puedes descargar los paquetes binarios desde el sitio web oficial de descargas de Apache Kafka.