La granularidad de los datos es el nivel de detalle con el que se guarda un dato: cuanto más se divide un campo, como separar nombre y apellidos, más granular es y más fácil de analizar. Es clave para un data engineer, que este año cobra de media unos 38.300 € en España según Indeed, y es base de cualquier bootcamp tecnológico online.
La granularidad de los datos hace referencia al nivel de detalle que posee un dato o una estructura de datos. En esta se evalúa la complejidad del tipo de dato y el tamaño en el que se dividen los campos de datos.
Es decir, la especificidad de cada dato va a influir en si la granularidad es de alto nivel o no. El tamaño del dato va a ser proporcional a su granularidad.
Supongamos que tenemos un campo con el atributo nombre. La granularidad de los datos en este caso va a estar definida por la manera en la que está dividido ese campo nombre: si es un solo campo o tiene subdivisiones de nombre 1, nombre 2, apellido 1 y apellido 2.
Si sucede que existen cuatro divisiones para el campo nombre, este dato va a ser más granular.
Ventajas de la granularidad de los datos
Una de las principales ventajas de la granularidad de los datos es que un dato bien granulado se puede moldear al antojo y cualquier analista de datos puede trabajar fácilmente con él.
«Divide y vencerás», dijeron grandes gobernantes en la antigüedad; precisamente esta es la máxima de la granularidad de los datos: al estar estructurados en partes pequeñas, los datos se vuelven mucho más manejables para los científicos de datos.
Esto quiere decir que el nivel de detalle de los datos alojados en la base de datos es muy importante cuando se trata de fusionar unos datos con otros o de crear estrategias de negocio.
Es importante comprender que cuando la granularidad de los datos no existe en una base de datos determinada, trabajar con esta información se vuelve una tarea sumamente ardua.
Alejandra trabajaba en el equipo de estrategia de una agencia de marketing y quería ir más allá de los informes: visualización de datos, modelos de ROI y decisiones basadas en datos.
Con el Bootcamp de Big Data, Inteligencia Artificial & Machine Learning de KeepCoding aprendió SQL, Python, Spark, modelado de datos y machine learning para transformar su perfil hacia un marketing data-driven.
👉 Lee el caso de éxito completo sobre marketing y análisis de datos aquí
De lo particular a lo general
Piensa en la granularidad de los datos como una metodología de investigación inductiva. Tenemos n registros de aves y, al final, concluimos que dado ese número de registros, todas las aves que tenemos son loros.
Del mismo modo funciona la granularidad de los datos; se parte de premisas o datos particulares (es decir, que es granular el conjunto de datos) para formar la conclusión o el resultado final, que sería la generalidad.
Sherlock Holmes: ¿un analista de datos?
Tal vez te suene haber leído sobre Sherlock Holmes y su método inductivo. La granularidad programacion consiste en generar un método inductivo que proponga alternativas de solución a problemas determinados.
En este caso, si nos vamos a lo específico, como buenos analistas, tendríamos que decir que no fue Sherlock el analista, sino Arthur Conan Doyle, su creador.
De hecho, Conan Doyle en muchas ocasiones resolvió casos en la vida real gracias al método inductivo que usaba en las novelas protagonizadas por el detective Holmes y su amigo Watson.
La especificidad de los datos nos sirve para determinar patrones de conducta, gustos o secretos de algo o alguien.
Cuando nos fijamos en los detalles más mínimos y los juntamos para formar distintas granuralidad de datos, podemos llegar a conclusiones inesperadas, como el descubrimiento de una infidelidad o a algún asesino escondido.
Un ejemplo
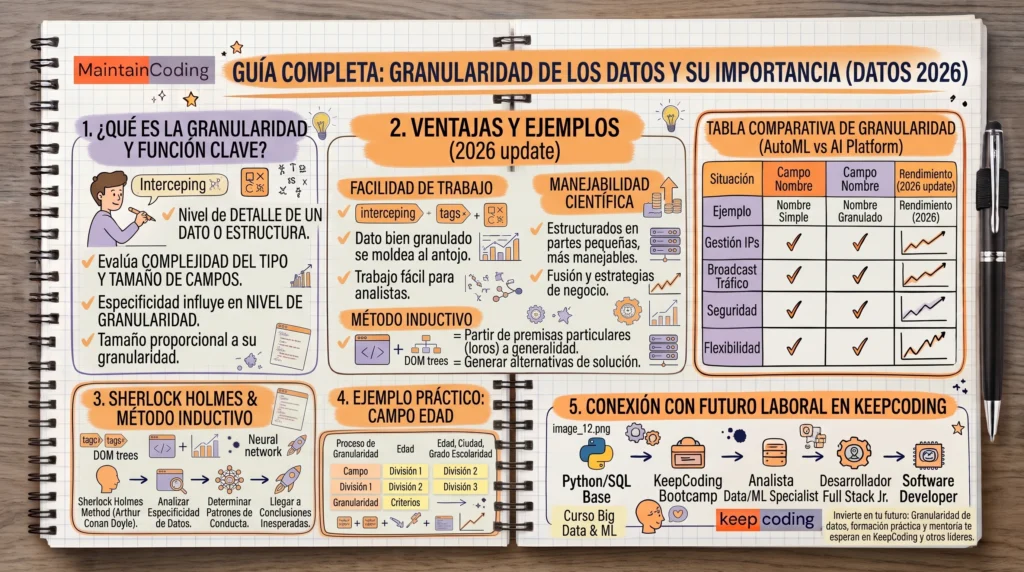
La siguiente tabla muestra el proceso de granularidad del campo edad, el cual se divide primero en edad, luego en edad y ciudad y, posteriormente, en edad, ciudad y grado de escolaridad.
Cuanto más granular sea la división de los datos, más criterios se usarán en cada campo.
Así se vería cada nivel de granularidad sobre un mismo registro:
| Nivel de granularidad | Campos | Ejemplo de registro |
|---|---|---|
| Baja | Edad | 34 |
| Media | Edad + ciudad | 34 · Madrid |
| Alta | Edad + ciudad + grado de escolaridad | 34 · Madrid · Universitario |
¿Por qué granularizar?
La principal razón para ejecutar la granularidad de los datos es la facilidad con la que estos se pueden abordar cuando se descomprimen en varias secciones.
Ser capaz de ajustar aspectos específicos a diferentes campañas o sectores puede traer beneficios a corto y largo plazo en las empresas, lo cual traería consecuencias positivas en la toma de decisiones y en la estrategia de negocio modelada.
Ser específico implica bastante trabajo, pero cuando se adoptan medidas distintas para una situación específica, en vez de adaptarse a medida que va ocurriendo el suceso, vemos que la granularidad de los datos se convierte en una gran ventaja competitiva en el mercado.
Para saber más
Si quieres seguir aprendiendo sobre conceptos de Big Data y machine learning, te invitamos a inscribirte en nuestro Bootcamp Full Stack Big Data, Inteligencia Artificial & Machine Learning, en el cual podrás aprender durante 9 meses todo acerca del gran mundo de los macrodatos, la analítica y la ciencia de datos.
¡Te esperamos!
Si quieres ver cómo se define la granularidad al diseñar un almacén de datos, consulta la técnica de declaración del grano de Kimball Group, referencia clásica del modelado dimensional.
Preguntas frecuentes sobre la granularidad de los datos
¿Qué es la granularidad en un data warehouse?
Es el nivel de detalle que representa cada fila de una tabla de hechos. Por ejemplo, una fila por cada venta individual es una granularidad alta; una fila por día y tienda, una granularidad baja. Definirla es el primer paso del modelado dimensional.
¿Es mejor una granularidad alta o baja?
Depende del uso. La granularidad alta da más flexibilidad para analizar, pero ocupa más espacio y ralentiza las consultas. La baja es más ligera, pero pierdes un detalle que después no podrás recuperar.
¿Se puede pasar de una granularidad alta a una baja?
Sí, agregando los datos con sumas, medias o conteos, por ejemplo con un GROUP BY en SQL. Al revés no es posible: si los datos se guardaron ya resumidos, el detalle original no se puede reconstruir.
¿Qué es la granularidad temporal?
Es la frecuencia con la que se registran los datos en el tiempo: por segundo, hora, día o mes. Condiciona qué tendencias puedes detectar y cuánto espacio de almacenamiento necesitas.
¿Qué relación tiene la granularidad con el RGPD?
Cuanto más granulares son los datos personales, más fácil resulta identificar a una persona. Por eso el RGPD exige el principio de minimización: guardar solo el nivel de detalle que realmente necesitas para tu finalidad.