
Las variables categóricas (o cualitativas) son aquellas que representan características, atributos o cualidades que no se miden con números reales, sino que toman un valor dentro de un conjunto limitado de clases. Se clasifican en nominales (sin orden implícito), ordinales (con jerarquía) y binarias (dos alternativas), y requieren ser codificadas a formato numérico (One-Hot Encoding, Label Encoding) para ser procesadas en modelos de Machine Learning y Big Data.
¿Sabes qué son las variables categóricas? ¿Las variables categóricas se pueden clasificar en ordinales, binarias y nominales?
Las variables categóricas son aquellas que no presentan un valor de un número real, sino una categoría; es decir, pueden tomar un valor dentro de un conjunto fijo y limitado de posibles valores, con o sin orden.
Si buscas especializarte en ciencia de datos, modelado predictivo e ingeniería de datos mediante un bootcamp de tecnología intensivo, dominar el tratamiento de variables cualitativas te dará la base necesaria para construir modelos precisos en entornos profesionales. Por ejemplo:
- Variables binarias: sí / no
- Categóricas con orden (ordinales): nada / poco / normal / mucho
- Categóricas sin orden (nominales): rojo / verde / azul
¿Cómo utilizar las variables categóricas?
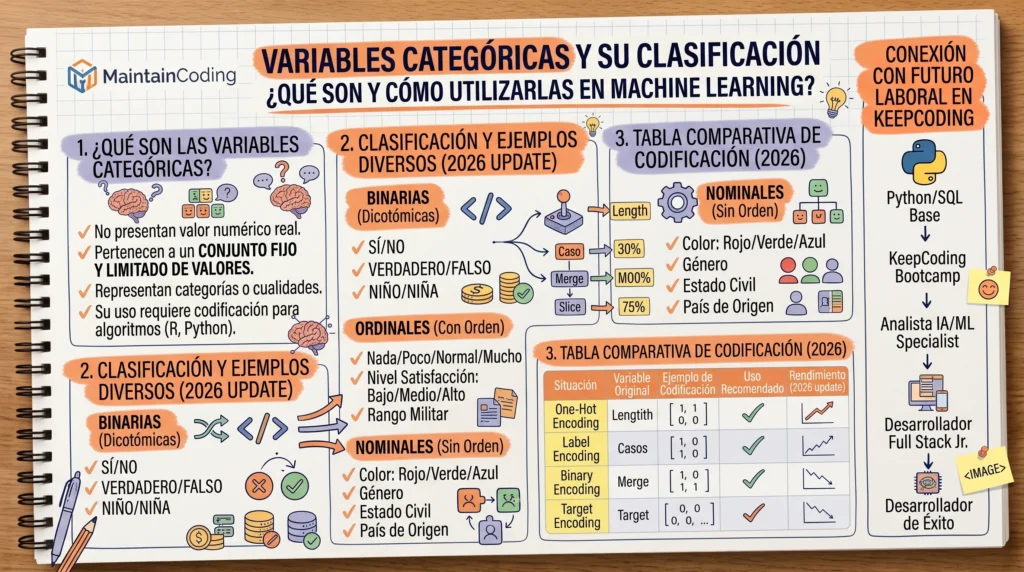
Antes de utilizar una de estas variables categóricas en un algoritmo de aprendizaje, hay que convertirla en un número real. Es necesario codificar la información (encoding) para que los algoritmos matemáticos y modelos de regresión o clasificación la interpreten correctamente.
«Aprender a procesar variables cualitativas y cuantitativas para construir modelos predictivos reales fue la clave para dar el salto profesional.»
Conoce la historia real de nuestros alumnos que, tras formarse en análisis de datos, Machine Learning y Big Data, lograron posicionarse en empresas clave del sector tecnológico.
👉 Lee este caso de éxito completo sobre análisis de datos aquí
Ejemplo de variables categóricas: altura de niños/niñas en función de la edad y del género
Queremos construir un modelo para calcular la longitud de un bebé en función de su edad en días y su peso en kg, analizando cómo influye la variable categórica género:
# Carga y preparación del dataset
df_weight_height <- read.csv("data/weight_babys.csv")
head(df_weight_height)

set.seed(123)
idx <- sample(1:nrow(df_weight_height), nrow(df_weight_height) * 0.7)
train.df <- df_weight_height[idx,]
test.df  <- df_weight_height[-idx,]
Exploramos cómo se relacionan las variables entre sí, analizando niños y niñas por separado. Se observa una alta correlación entre peso, altura y edad.
# Análisis exploratorio visual con GGally
library(GGally)
options(repr.plot.height = 4, repr.plot.width = 6)

ggpairs(df_weight_height, ggplot2::aes(colour = gender, alpha = 0.5),
        lower = list(continuous = wrap("points", alpha = 0.8, size = 0.1)))
Como queremos hacer un modelo predictivo, dividimos los datos entre entrenamiento (train) y prueba (test):
set.seed(123)
idx <- sample(1:nrow(df_weight_height), nrow(df_weight_height) * 0.7)
train.df <- df_weight_height[idx,]
test.df  <- df_weight_height[-idx,]
Ajustamos la fórmula de regresión lineal donde gender es una variable categórica binaria que se traducirá numéricamente (por ejemplo: Boy = 0, Girl = 1):
model <- lm(data = train.df, formula = height ~ day + gender)
summary(model)
A igual número de días, una niña medirá, aproximadamente, una media de 1.07 cm menos en la muestra ajustada. Sin embargo, si miramos al intervalo de confianza del coeficiente asociado al género, se analiza su amplitud:
confint(model)
#                   2.5 %        97.5 %
# (Intercept) 61.48691887  64.91457799
# day          0.02685145   0.02987543
# gendergirl  -2.63965925   0.50130757
Evaluamos la calidad del modelo mediante métricas de error (RMSE, MAE y R²):
library(caret)

print("Training:")
train.df$pred <- predict(model, train.df)
postResample(train.df$pred, obs = train.df$height)

print("Testing:")
test.df$pred <- predict(model, test.df)
postResample(test.df$pred, obs = test.df$height)

# [1] "Training:"
# RMSE: 4.6246035  Rsquared: 0.9146361  MAE: 3.7407511
# [1] "Testing:"
# RMSE: 4.2239352  Rsquared: 0.9173109  MAE: 3.3127036
Representamos las predicciones según la categoría:
ggplot(train.df, aes(x = day, y = pred, color = gender)) + geom_line()Al graficar, tendríamos dos rectas paralelas: una para niños y otra para niñas, desplazadas entre sí según el coeficiente obtenido para la variable categórica.
| Tipo de Categórica | Definición y Estructura | Ejemplo Típico |
|---|---|---|
| Binaria / Dicotómica | Solo admite dos estados excluyentes. | Sí / No, Verdadero / Falso, 0 / 1. |
| Nominal | Múltiples categorías sin ningún orden o jerarquía. | País, color, estado civil, tipo de dispositivo. |
| Ordinal | Categorías que siguen un orden o escala clara. | Nivel de satisfacción (Bajo/Medio/Alto), rango militar. |
El análisis y la codificación de variables categóricas es una tarea fundamental en proyectos de Big Data y Machine Learning, ya que siempre se requiere realizar análisis de corte estadístico tanto cuantitativa como cualitativamente.
Si quieres seguir aprendiendo y dominar el tratamiento de datos para la construcción de modelos inteligentes, te invitamos a inscribirte en nuestro Bootcamp de Inteligencia Artificial Full Stack, en donde, en poco tiempo, aprenderás todo lo necesario para incursionar en el mercado laboral. ¡Anímate a solicitar más información para cambiar tu vida profesional!
Conclusión
Comprender cómo identificar, clasificar y codificar las variables categóricas es un paso indispensable en la preparación de datos (data preprocessing) para análisis estadísticos y algoritmos de Machine Learning. Saber transformar cualitativamente información cualitativa mediante técnicas como One-Hot Encoding o Label Encoding permite crear modelos predictivos precisos, estables y directamente aplicables a problemas del mundo real.
Si quieres aprender ciencia de datos, Machine Learning, Deep Learning y procesamiento avanzado de datos con la guía de expertos en activo del sector IT, descubre el Bootcamp de Inteligencia Artificial Full Stack de KeepCoding e impulsa tu carrera tecnológica hoy mismo.
Para profundizar en métodos de codificación y manipulación de datos categóricos en R y Python, te sugerimos revisar la guía de R for Data Science sobre factores y variables categóricas.
Preguntas Frecuentes sobre Tipos de Variables y Datos Categóricos
¿Cuáles son los 4 tipos de variables?
En estadística y ciencia de datos, las variables se dividen principalmente en 4 tipos según su escala de medida: 1. Cualitativa nominal, 2. Cualitativa ordinal, 3. Cuantitativa discreta y 4. Cuantitativa continua.
¿Qué son variables continuas y categóricas?
Las variables categóricas (o cualitativas) representan atributos, grupos o etiquetas sin valor numérico inherente (como el género o el color), mientras que las variables continuas son numéricas y pueden tomar un número infinito de valores dentro de un rango (como la altura o el peso).
¿Qué es una variable cualitativa o categórica?
Es aquel tipo de variable que describe cualidades, categorías o atributos no numéricos de un elemento o individuo, permitiendo clasificar los datos en diferentes grupos.
¿Cuáles son los datos categóricos?
Los datos categóricos son valores que dividen la información en grupos específicos o etiquetas. Se clasifican en nominales (sin un orden intrínseco, como ‘país de origen’) y ordinales (con una jerarquía u orden establecido, como ‘nivel educativo’).
¿Qué es una variable categórica y ejemplos?
Una variable categórica asigna un individuo o caso a una categoría definida. Ejemplos incluyen: estado civil (soltero, casado), nivel de satisfacción (bajo, medio, alto) o tipo de sistema operativo (Windows, macOS, Linux).
¿Cuáles son los 4 tipos de datos?
En análisis de datos y estadística, los 4 niveles o tipos de datos más comunes son: Nominales, Ordinales, de Intervalo y de Razón.