
Las métricas en clasificación son valores numéricos que evalúan la precisión y efectividad de un modelo de machine learning al asignar observaciones a categorías o clases específicas dentro de un conjunto de datos.
Generalmente, el rendimiento se presenta en un rango de 0 a 1, donde la puntuación 1 corresponde a un modelo perfecto, clasificado correctamente.
Una de las métricas en clasificación más usadas es el accuracy o métrica de precisión, que muchas veces vemos representado con tres letras: ACC. Si tu meta es especializarte en análisis de datos, modelos predictivos y algoritmos avanzados mediante un bootcamp de tecnología intensivo, aprender a seleccionar y evaluar métricas de rendimiento te dará las bases para optimizar modelos de producción con rigor científico.
En este post veremos algunas generalidades de las métricas en clasificación, para que entiendas cómo funciona este concepto y cómo aplicarlo correctamente en los problemas de tu conjunto de datos en machine learning. No obstante, existen muchas otras métricas en clasificación y hay que tener mucho cuidado en validar cuál usamos en nuestros modelos, porque una mala métrica probablemente se convierta en un mal resultado.
Teoría de la decisión: métricas en clasificación
La teoría de la decisión es una de las métricas en clasificación en la que tenemos dos variables: la azul, que corresponde a 0 y tiene la fórmula $P(y = 0 \mid x)$; y la roja, a la que le corresponde el valor 1 y cuya fórmula es $P(y = 1 \mid x)$.
Este problema pertenece a los problemas de clasificación binaria y la línea negra del centro actúa como clasificador.
Un clasificador lo que hará en un espacio de dos dimensiones o más (solo que por cuestiones de practicidad no tenemos más de dos dimensiones, ya que no se pueden pintar) es dividir en dos, establecer una frontera y decidir que todo lo que hay a un lado de la frontera es una cosa, por lo que todo lo que hay al otro lado de la frontera es otra cosa diferente.

Entonces, si bien no hay eje x, vamos a asumir que la frontera está, más o menos, en el 0.5. ¿Por qué en este valor? Recordemos que el rendimiento de las métricas en clasificación va de 0 a 1, por tanto, como el clasificador está partiendo los datos más o menos por la mitad, deducimos que la frontera es 0.5.
Si movemos la línea negra al lado izquierdo, se van a tomar más datos o instancias del lado derecho. Si, por el contrario, movemos la línea negra hacia el lado derecho, se van a tomar más instancias del lado izquierdo.
«Pensaba que sin background técnico no podría entrar en la tecnología, pero en pocos meses cambié mi carrera hacia el análisis de datos e IA.»
Conoce la historia real de Ángel Olivares, quien dio un giro profesional radical y pasó de un sector ajeno al software a liderar proyectos de gestión de datos e Inteligencia Artificial en el mercado IT.
Métricas en clasificación: tasa de error
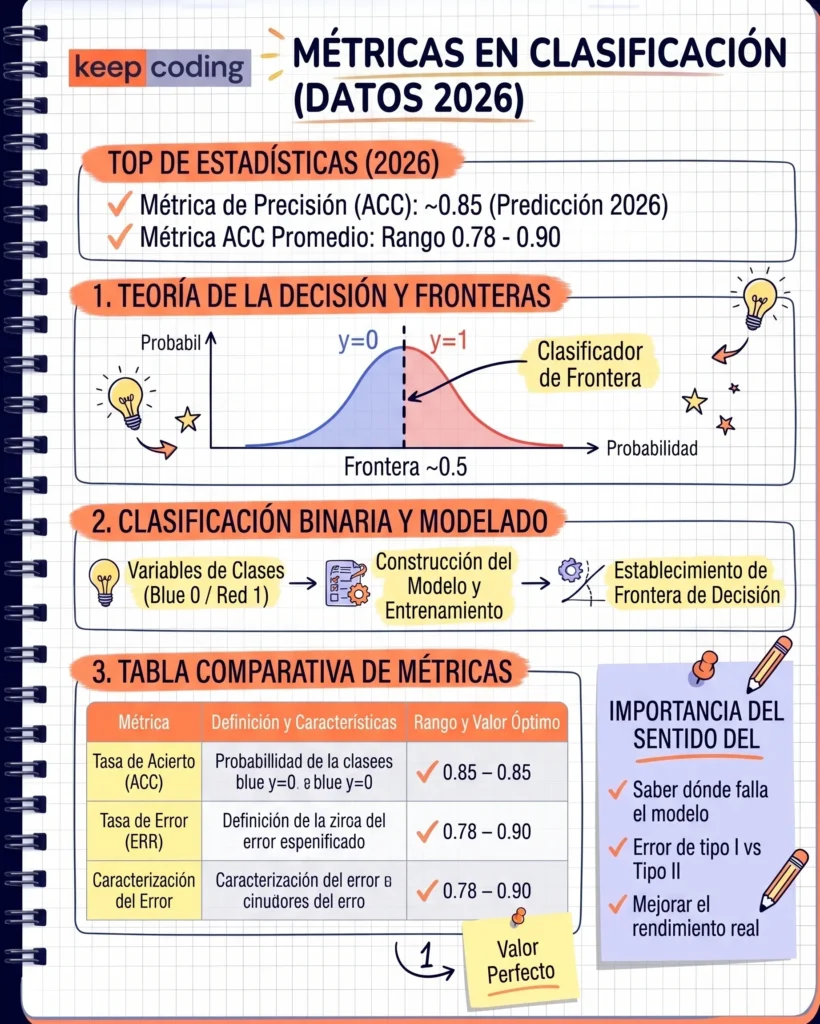
Una de las métricas en clasificación que existen es la tasa de error. Esta es la métrica más sencilla y su simplicidad radica en que solo se basa en contar errores.
Veamos un pequeño ejemplo para entender mejor el concepto. Tenemos que el True corresponde a las etiquetas reales y el Pred corresponde a las etiquetas predichas. Entonces, la primera etiqueta es un acierto, la segunda es un error, la tercera es un acierto y así sucesivamente con todas las etiquetas.
True: [1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 0, 0, 0]
Pred: [1, 0, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0, 0, 0, 0, 1, 1, 0, 0, 1]
La tasa de error es el número de errores dividido entre el número de muestras ($N$).
La tasa de acierto, es decir, el accuracy, es igual al número de aciertos dividido entre el número total de muestras.
- Tasa de error (ERR): $\text{número de errores} / N$
- Tasa de acierto (ACC): $\text{número de aciertos} / N$
- $\text{ACC} = 1 – \text{ERR}$
¿Cuál es el problema de esto? Que no hay una caracterización, una identificación del error. Es decir, da igual el sentido del error.
Esto significa que el segundo caso es un error, porque la etiqueta real es un 1 y nosotros estamos prediciendo un 0. Más adelante tenemos otro caso contrario, en donde el original es 0 y la métrica usada nos está arrojando un 1.
En algunos casos esto no importará, pero habrá otros casos en los que el sentido del error sí será relevante para llevar a cabo determinado ejercicio.
| Métrica | Fórmula / Concepto | Limitación Principal |
|---|---|---|
| Accuracy (ACC) | Aciertos totales / N | Inducido a error en datasets desbalanceados. |
| Error Rate (ERR) | Errores totales / N | No diferencia falsos positivos de falsos negativos. |
| Matriz de Confusión | Detalle por VP, VN, FP, FN | Requiere analizar múltiples valores a la vez. |
¿Quieres seguir aprendiendo?
Para que cumplas tus sueños y sigas aprendiendo sobre el mundo tecnológico, que ofrece grandes oportunidades para desarrolladores y aspirantes a data scientist, tenemos para ti el Bootcamp Big Data, Machine Learning & IA Full Stack. En esta formación íntegra e intensiva adquirirás todos los conocimientos teóricos y prácticos para que sigas tu camino hacia el éxito en el mundo IT. ¡No esperes más para cumplir tus metas y solicita información ahora!
Conclusión
Dominar las métricas en clasificación y comprender el impacto de la frontera de decisión es esencial para evaluar correctamente el desempeño de modelos predictivos en machine learning. Saber diferenciar cuándo el acierto simple es suficiente y cuándo es necesario profundizar en matrices de confusión evita diagnósticos erróneos en proyectos reales de ciencia de datos e inteligencia artificial.

Si quieres especializarte en análisis masivo de datos, algoritmos predictivos, deep learning e inteligencia artificial aplicada con mentores en activo, descubre el Bootcamp Big Data, Machine Learning & IA Full Stack de KeepCoding e impulsa tu carrera tecnológica hoy mismo.
Para profundizar en los fundamentos matemáticos y la evaluación de clasificadores estadísticos, puedes revisar la documentación oficial sobre evaluación de modelos en Scikit-Learn.
Preguntas Frecuentes sobre Métricas e Indicadores de Desempeño
¿Qué son las métricas de clasificación?
Las métricas de clasificación son medidas cuantitativas utilizadas en Machine Learning para evaluar el rendimiento y precisión de un modelo supervisado al categorizar datos en diferentes clases o etiquetas.
¿Cuáles son los tipos de métricas?
Los tipos principales de métricas en Machine Learning incluyen métricas de clasificación (Accuracy, Precision, Recall, F1-Score, ROC-AUC), métricas de regresión (MSE, RMSE, MAE, R²) y métricas de agrupación o clustering (Silhouette Score).
¿Qué tipos de métricas hay?
Existen métricas de rendimiento técnico (para evaluar modelos de inteligencia artificial y código), métricas de negocio o KPIs (para medir rentabilidad y conversión) y métricas de usuario o producto (para evaluar retención y experiencia de uso).
¿Cuáles son las métricas a evaluar?
En un problema de clasificación, las métricas clave a evaluar son la Exactitud (Accuracy), Precisión (Precision), Sensibilidad o Exhaustividad (Recall), la puntuación F1 (F1-Score) y el Área Bajo la Curva ROC (AUC-ROC).
¿Qué son las métricas y ejemplos?
Las métricas son valores numéricos estandarizados para monitorear y evaluar un proceso. Por ejemplo, en e-commerce la Tasa de Conversión; en desarrollo web el Tiempo de Carga (LCP); y en un filtro de spam el porcentaje de Correos Correctamente Detectados.
¿Cuáles son los 4 indicadores de desempeño más importantes?
Los 4 indicadores clave de desempeño (KPI) habituales son: 1. Indicadores de Calidad (nivel de precisión o satisfacción), 2. Indicadores de Capacidad (volumen de producción), 3. Indicadores de Eficiencia (uso óptimo de recursos) y 4. Indicadores de Rentabilidad/ROI.